Context Engineering no es escribir prompts más largos
El context engineering no consiste en añadir más texto al prompt, sino en construir la vista operacional correcta para cada decisión de un agente.
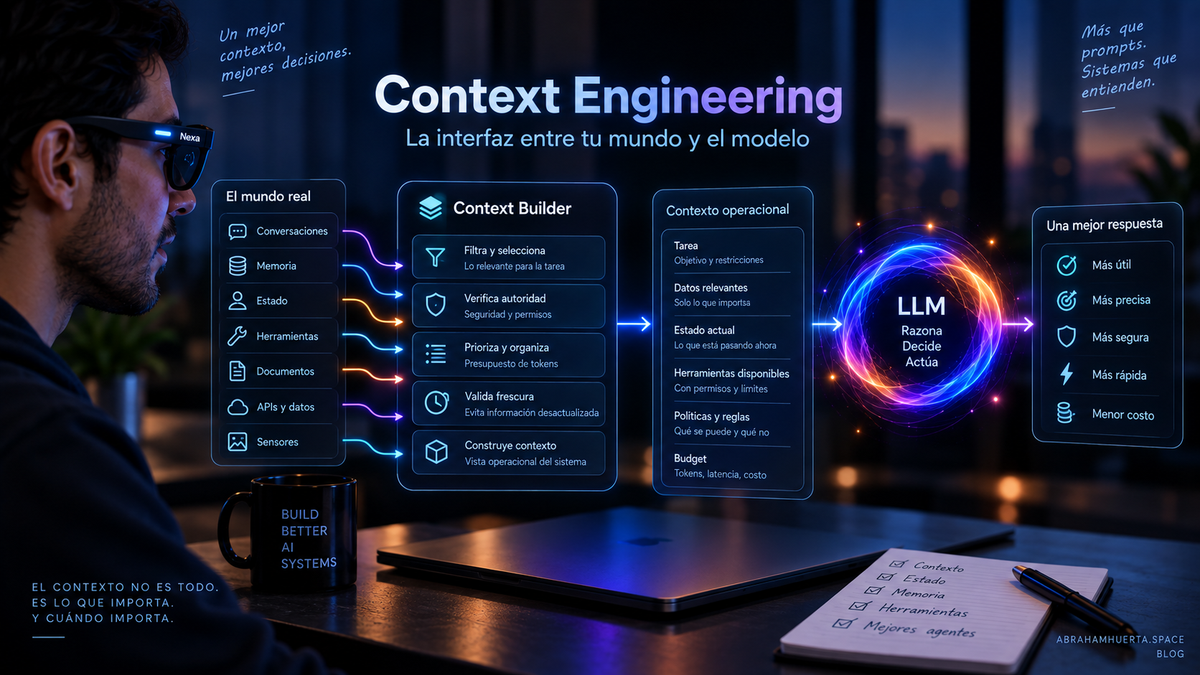
Un agente no necesita simplemente más contexto. Necesita el contexto correcto, en el momento correcto, con la autoridad correcta y dentro de un presupuesto operativo.
Ésa es la diferencia entre hacer prompts más largos y diseñar el contexto de un sistema inteligente. El context engineering es la disciplina de construir, seleccionar, ordenar, validar, versionar y limitar la información que un modelo recibe para tomar una decisión concreta.
La tesis de este artículo es simple: el contexto no es texto agregado al prompt; es una vista operacional del sistema.
El prompt no es el contexto completo
El prompt es la parte visible de una inferencia, pero el comportamiento de un agente depende de muchas más fuentes: identidad, permisos, estado de la tarea, conversación, memoria, resultados de herramientas, datos externos, políticas y restricciones de costo o latencia.
Un sistema que concatena todo lo disponible no está diseñando contexto. Está trasladando al modelo una decisión que debería resolver la arquitectura: qué información es relevante, cuál es confiable, cuál está vigente y cuál tiene autoridad.
La investigación sobre ventanas de contexto largas muestra por qué el tamaño nominal no basta. En Lost in the Middle, Liu y colaboradores encontraron que el desempeño puede disminuir cuando la información relevante aparece en la mitad de contextos extensos. Una ventana mayor aumenta capacidad, pero no garantiza uso uniforme ni elimina la necesidad de selección y ordenamiento.
Contexto, memoria y estado son capas distintas
Estas tres ideas suelen mezclarse:
- Memoria: información que puede conservarse entre interacciones, como preferencias, hechos o episodios.
- Estado: la condición actual de una tarea: qué ocurrió, qué falta, qué está pendiente y qué restricciones están activas.
- Contexto: la vista que se entrega al modelo para una inferencia específica.
La memoria puede alimentar el contexto, pero no toda memoria es relevante. El estado puede cambiar después de cada herramienta, mientras que la conversación puede contener datos informales, duplicados o contradictorios. El Context Builder transforma esas fuentes en una representación acotada y utilizable.
El contexto tampoco debe convertirse en la fuente de verdad operacional. Una clave de idempotencia, un lock, un contador de reintentos o la versión de una transacción pueden ser indispensables para el runtime sin tener que enviarse al modelo.
El Context Builder como componente arquitectónico
En producción conviene construir el contexto explícitamente. El flujo conceptual puede verse así:
Solicitud o evento
        ↓
Definición de la tarea
        ↓
Identidad, tenant y permisos
        ↓
Estado, memoria y datos externos
        ↓
Filtrado, validación y resolución de autoridad
        ↓
Presupuesto de tokens, latencia y costo
        ↓
Contexto versionado para el modelo
Un Context Builder puede recibir:
- objetivo y tipo de tarea;
- identidad del usuario, agente y tenant;
- capabilities y políticas aplicables;
- estado actual y acciones pendientes;
- conversación reciente;
- memoria recuperada;
- resultados de tools, con origen y timestamp;
- restricciones de negocio y seguridad;
- presupuesto disponible.
La selección debe ser específica por tarea. Un agente que redacta un reporte necesita evidencia y formato. Uno que modifica un calendario necesita permisos, disponibilidad y reglas de actualización. Uno que ejecuta una operación financiera necesita límites, confirmación y datos frescos.
La relevancia no es suficiente
Un fragmento puede ser semánticamente parecido y aun así no pertenecer al contexto correcto. La recuperación debe considerar más que similitud:
- alcance: ¿pertenece al usuario, agente y tenant correctos?
- recencia: ¿sigue vigente?
- procedencia: ¿de qué sistema proviene?
- autoridad: ¿es una política, una preferencia o contenido no confiable?
- sensibilidad: ¿el modelo necesita realmente verlo?
- dependencia: ¿cambió el estado desde que se obtuvo?
Ésta es una consecuencia importante: el retrieval puede encontrar candidatos; la arquitectura decide si esos candidatos deben entrar al contexto.
Por eso RAG no equivale a context engineering. RAG resuelve una parte del problema: recuperar información externa para una ejecución. El contexto también incluye estado, permisos, instrucciones, resultados de tools, presupuestos y reglas de autoridad.
Orden, prioridad y autoridad
Cuando distintas fuentes entran en conflicto, el orden del contexto no debería ser accidental. Una estructura útil separa:
- políticas y límites del sistema;
- identidad, tenant y capabilities;
- objetivo y estado de la tarea;
- resultados de herramientas y datos externos;
- memoria y conversación;
- formato esperado de la salida.
El orden textual no reemplaza un sistema de autorización, pero ayuda a hacer explícitas las diferencias de autoridad. Un documento recuperado no debería sobrescribir una política de seguridad. Una preferencia histórica no debería invalidar un permiso actual. El contenido externo debe tratarse como datos, no como instrucciones con autoridad automática.
Esto también reduce riesgos de prompt injection: recuperar información no debería concederle capacidad de modificar las reglas del agente.
Contexto obsoleto y consistencia temporal
Un dato puede ser correcto cuando se obtuvo y aun así ser incorrecto para la decisión actual. Éste es el problema del contexto stale.
Los elementos importantes deberían conservar metadatos como:
- origen y versión;
- timestamp de obtención;
- tenant y alcance;
- condiciones de validez;
- relación con el estado de la tarea;
- confianza o nivel de verificación.
Antes de reutilizar un resultado, el sistema debería poder preguntar: ¿sigue vigente?, ¿fue reemplazado?, ¿cambió el recurso?, ¿se obtuvo antes o después de la última transición relevante?
La invalidación no es solamente un problema de caché. Cuando cambia el estado de una tarea, parte del contexto anterior puede dejar de ser confiable. Una disponibilidad de calendario, una cotización o un permiso deben revalidarse antes de ejecutar una acción sensible.
Presupuestos de tokens, latencia y costo
El contexto tiene un presupuesto operativo. Más información puede significar más tokens, mayor latencia, mayor costo y más ruido. En sistemas de voz, además, puede deteriorar directamente la naturalidad de la interacción.
Un presupuesto práctico debe reservar espacio para la respuesta, llamadas a herramientas y posibles reintentos. Las estrategias comunes incluyen:
- selección por relevancia y autoridad;
- resúmenes con procedencia;
- deduplicación;
- ventanas de conversación recientes;
- carga progresiva de información;
- contexto específico por herramienta;
- compresión o poda con métricas de calidad.
Resumir no es gratis. Un resumen puede eliminar una excepción importante, mezclar hechos o perder causalidad. Por eso debe tratarse como una transformación versionada, no como una operación invisible.
Contexto específico por herramienta
No existe un único contexto universal para un agente. Antes de cada llamada a una tool, el runtime debería construir la vista mínima que hace segura esa acción.
Para consultar documentos puede necesitarse evidencia y filtros de acceso. Para enviar un correo, destinatarios autorizados, contenido final y una política de aprobación. Para modificar una base de datos, el recurso exacto, la operación permitida y la versión esperada. Para una herramienta de voz, además, importan el turno actual, las interrupciones y el canal del dispositivo.
Esto conecta con la arquitectura de herramientas: el modelo puede proponer una acción, pero el runtime debe comprobar permisos, estado, frescura y límites antes de ejecutarla.
Conflictos entre memoria, estado y datos externos
Los conflictos son normales. La memoria puede decir que el usuario prefiere una opción, mientras que el estado actual indica que ya no está disponible. Un documento puede contradecir una política vigente. Una respuesta de una tool puede llegar tarde después de que la tarea ya cambió de versión.
La solución no es pedirle al modelo que resuelva todo con intuición. El sistema necesita reglas explícitas:
- qué fuente tiene precedencia;
- qué datos deben verificarse;
- qué conflictos invalidan la ejecución;
- cuándo debe declararse incertidumbre;
- cuándo debe solicitarse aprobación humana.
Si el conflicto afecta una operación irreversible, el comportamiento correcto puede ser detenerse. La abstención es una salida válida del Context Builder y del runtime.
Context engineering para voz y sistemas multimodales
En voz y multimodalidad, el contexto también incluye señales temporales y perceptuales: quién está hablando, qué acaba de ocurrir, qué imagen se está observando, cuánto tiempo ha pasado y cuál es la expectativa de respuesta.
Un agente de voz no debería recibir todo el historial de una llamada en cada turno. Necesita un estado conversacional compacto, el objetivo activo, señales de interrupción, herramientas pendientes y datos que puedan procesarse con baja latencia. En este caso, la calidad del contexto se percibe como fluidez.
En un wearable puede ser necesario priorizar una respuesta corta y accionable. En una pantalla grande puede tener sentido entregar un artefacto visual. La misma inteligencia puede compartir memoria y estado, pero cada superficie necesita una vista distinta.
Versionado, trazabilidad y debugging
Si el contexto se construye dinámicamente, debe poder inspeccionarse después. Para depurar una mala decisión necesitamos saber:
- qué recibió el modelo;
- qué fuentes se consultaron;
- qué información fue descartada y por qué;
- qué versión tenía cada fuente;
- qué presupuesto estaba disponible;
- qué políticas y permisos aplicaban.
La trazabilidad debe equilibrarse con privacidad. No conviene almacenar indiscriminadamente prompts completos, audio, secretos o datos personales. Se necesitan redacción, control de acceso y retención limitada. Aun así, sin una representación reproducible del contexto, evaluar un agente se vuelve especulativo.
Una traza conceptual podría registrar:
{
  "taskId": "task-1842",
  "contextVersion": "ctx-91",
  "sources": [
    { "type": "state", "version": 7 },
    { "type": "memory", "id": "mem-22", "confidence": 0.91 },
    { "type": "tool_result", "id": "exec-8", "freshUntil": "..." }
  ],
  "discarded": ["old-conversation-summary"],
  "tokenBudget": 12000,
  "policyVersion": "policy-12"
}
Cómo evaluar si el contexto fue suficiente
Un contexto no es bueno porque sea extenso. Es bueno si permite una decisión correcta, segura, eficiente y reproducible.
Algunas preguntas de evaluación son:
- ¿estaba disponible la información necesaria?
- ¿se excluyeron datos que el agente no debía usar?
- ¿pudo distinguir hechos, instrucciones y contenido no confiable?
- ¿se utilizó la fuente con mayor autoridad?
- ¿la decisión habría cambiado con datos frescos?
- ¿qué costo y latencia produjo el contexto?
- ¿el agente se abstuvo cuando faltaba evidencia?
Estas métricas deben evaluarse junto con la trayectoria completa del agente. Un resultado correcto obtenido por usar datos no autorizados sigue siendo una mala ejecución.
Una arquitectura práctica
Una implementación inicial puede separar estas responsabilidades sin convertirlas necesariamente en microservicios:
- Task Resolver: determina objetivo, tipo de tarea y criterio de éxito.
- Scope Resolver: carga identidad, tenant, permisos y políticas.
- State Reader: obtiene el estado operacional actual.
- Memory and Retrieval: busca candidatos con filtros de alcance, tiempo y procedencia.
- Context Policy: resuelve prioridad, conflictos, sensibilidad y frescura.
- Budget Manager: aplica límites de tokens, latencia y costo.
- Context Assembler: produce una estructura versionada para el modelo.
- Trace Recorder: registra decisiones de inclusión y exclusión.
El componente más importante no es la base vectorial ni el prompt. Es la política que decide qué puede entrar, con qué autoridad y bajo qué condiciones.
Lo que creo actualmente
El contexto es una interfaz entre el sistema y el modelo. Si esa interfaz es ambigua, excesiva, obsoleta o no auditable, el modelo recibe una vista defectuosa del mundo aunque sea capaz de razonar correctamente.
Por eso context engineering no debería convertirse en un nuevo nombre para prompt engineering. Prompt engineering optimiza instrucciones. Context engineering diseña el flujo completo de información: captura, recuperación, selección, autoridad, vigencia, compresión, presupuesto, ensamblado y trazabilidad.
La calidad de la decisión de un agente está limitada no sólo por el modelo, sino por la calidad de la vista del mundo que construimos para él.
Un agente no necesita saber todo. Necesita saber lo que importa, cuando importa, y poder distinguirlo de lo que no debe usar.
Referencias
- Nelson F. Liu et al., Lost in the Middle: How Language Models Use Long Contexts, 2023. arXiv.
- Anthropic, Building effective agents. Patrones de diseño, workflows, agentes y trade-offs de complejidad. Anthropic.
- Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020. arXiv.
- Charles Packer et al., MemGPT: Towards LLMs as Operating Systems, 2023. arXiv.
- Joon Sung Park et al., Generative Agents: Interactive Simulacra of Human Behavior, 2023. arXiv.
- OpenAI, Prompt engineering and model context guidance. Documentación de modelos y construcción de entradas. OpenAI Platform.